
基于湖库一体架构,统一管理结构化、半结构化与非结构化等多模态数据,一个系统承载事务处理、实时分析与 AI 工作负载。


划线反馈
使用 sql_plan_monitor 与 monitor dump 诊断正确性问题
更新时间:2024-04-11 06:06
分享
适用版本:V2.1.x、V2.2.x、V3.1.x、V3.2.x内容类型:Troubleshoot
并行执行返回结果不正确,有关复杂执行计划正确性问题,其并行、串行执行结果集不一致。本文总结一下排查过程中的有效操作。
诊断流程
同一个 SQL,并行执行结果和串行执行结果不一致。当计划特别复杂时,缩小问题排查范围很重要。
步骤一:通过 sql_audit 与 sql_plan_monitor 获取 SQL 的 TRACE ID 值
分别对串行 SQL、并行 SQL 执行如下操作。
确认
sql_plan_monitor是否已开启。show parameters like 'enable_sql_audit';## 如果 enable_sql_audit = False 则将其开启。 alter system enable_sql_audit = true;获取 SQL 执行计划。
explain xxxxxx;执行 SQL。
临时关闭 monitor 数据,防止刷掉。
确认
enable_sql_audit是否已开启。show parameters like 'enable_sql_audit';如果 enable_sql_audit = Ture 则将其关闭。
alter system enable_sql_audit = False;
获取 SQL 的 TRACE ID(Yxxxxxxxxx)获取每个算子的吐行信息。
MySQL 租户。
select plan_line_id, plan_operation, sum(output_rows), sum(STARTS) rescan, min(first_refresh_time) open_time, max(last_refresh_time) close_time, min(first_change_time) first_row_time, max(last_change_time) last_row_eof_time, count(1) from oceanbase.gv$sql_plan_monitor where trace_id = 'Yxxxxxxxxx' group by plan_line_id, plan_operation order by plan_line_id;Oracle 租户。
select plan_line_id, plan_operation, sum(output_rows), sum(STARTS) rescan, min(first_refresh_time) open_time, max(last_refresh_time) close_time, min(first_change_time) first_row_time, max(last_change_time) last_row_eof_time, count(1) from sys.gv$sql_plan_monitor where trace_id = 'Yxxxxxxxxx' group by plan_line_id, plan_operation order by plan_line_id;
恢复 sql_audit。
alter system enable_sql_audit = true;
步骤二:分析
完成上述诊断流程后,将 explain 结果、sql_plan_monitor 结果打包发回分析。结合计划,逐个算子对比 sql_plan_monitor 中的数据,查看行数从哪里起不一致。串行、并行计划中有很多干扰算子,可以用下面的命令处理一下。
grep -v "EXCHANGE" monitor_result.txt | grep -v MATERIAL | grep -v "PX " | grep -v "SUBPLAN SCAN" | grep -v "TRANSMIT" | grep -v "RECEIVE" | sed '/^[ ]*$/d'
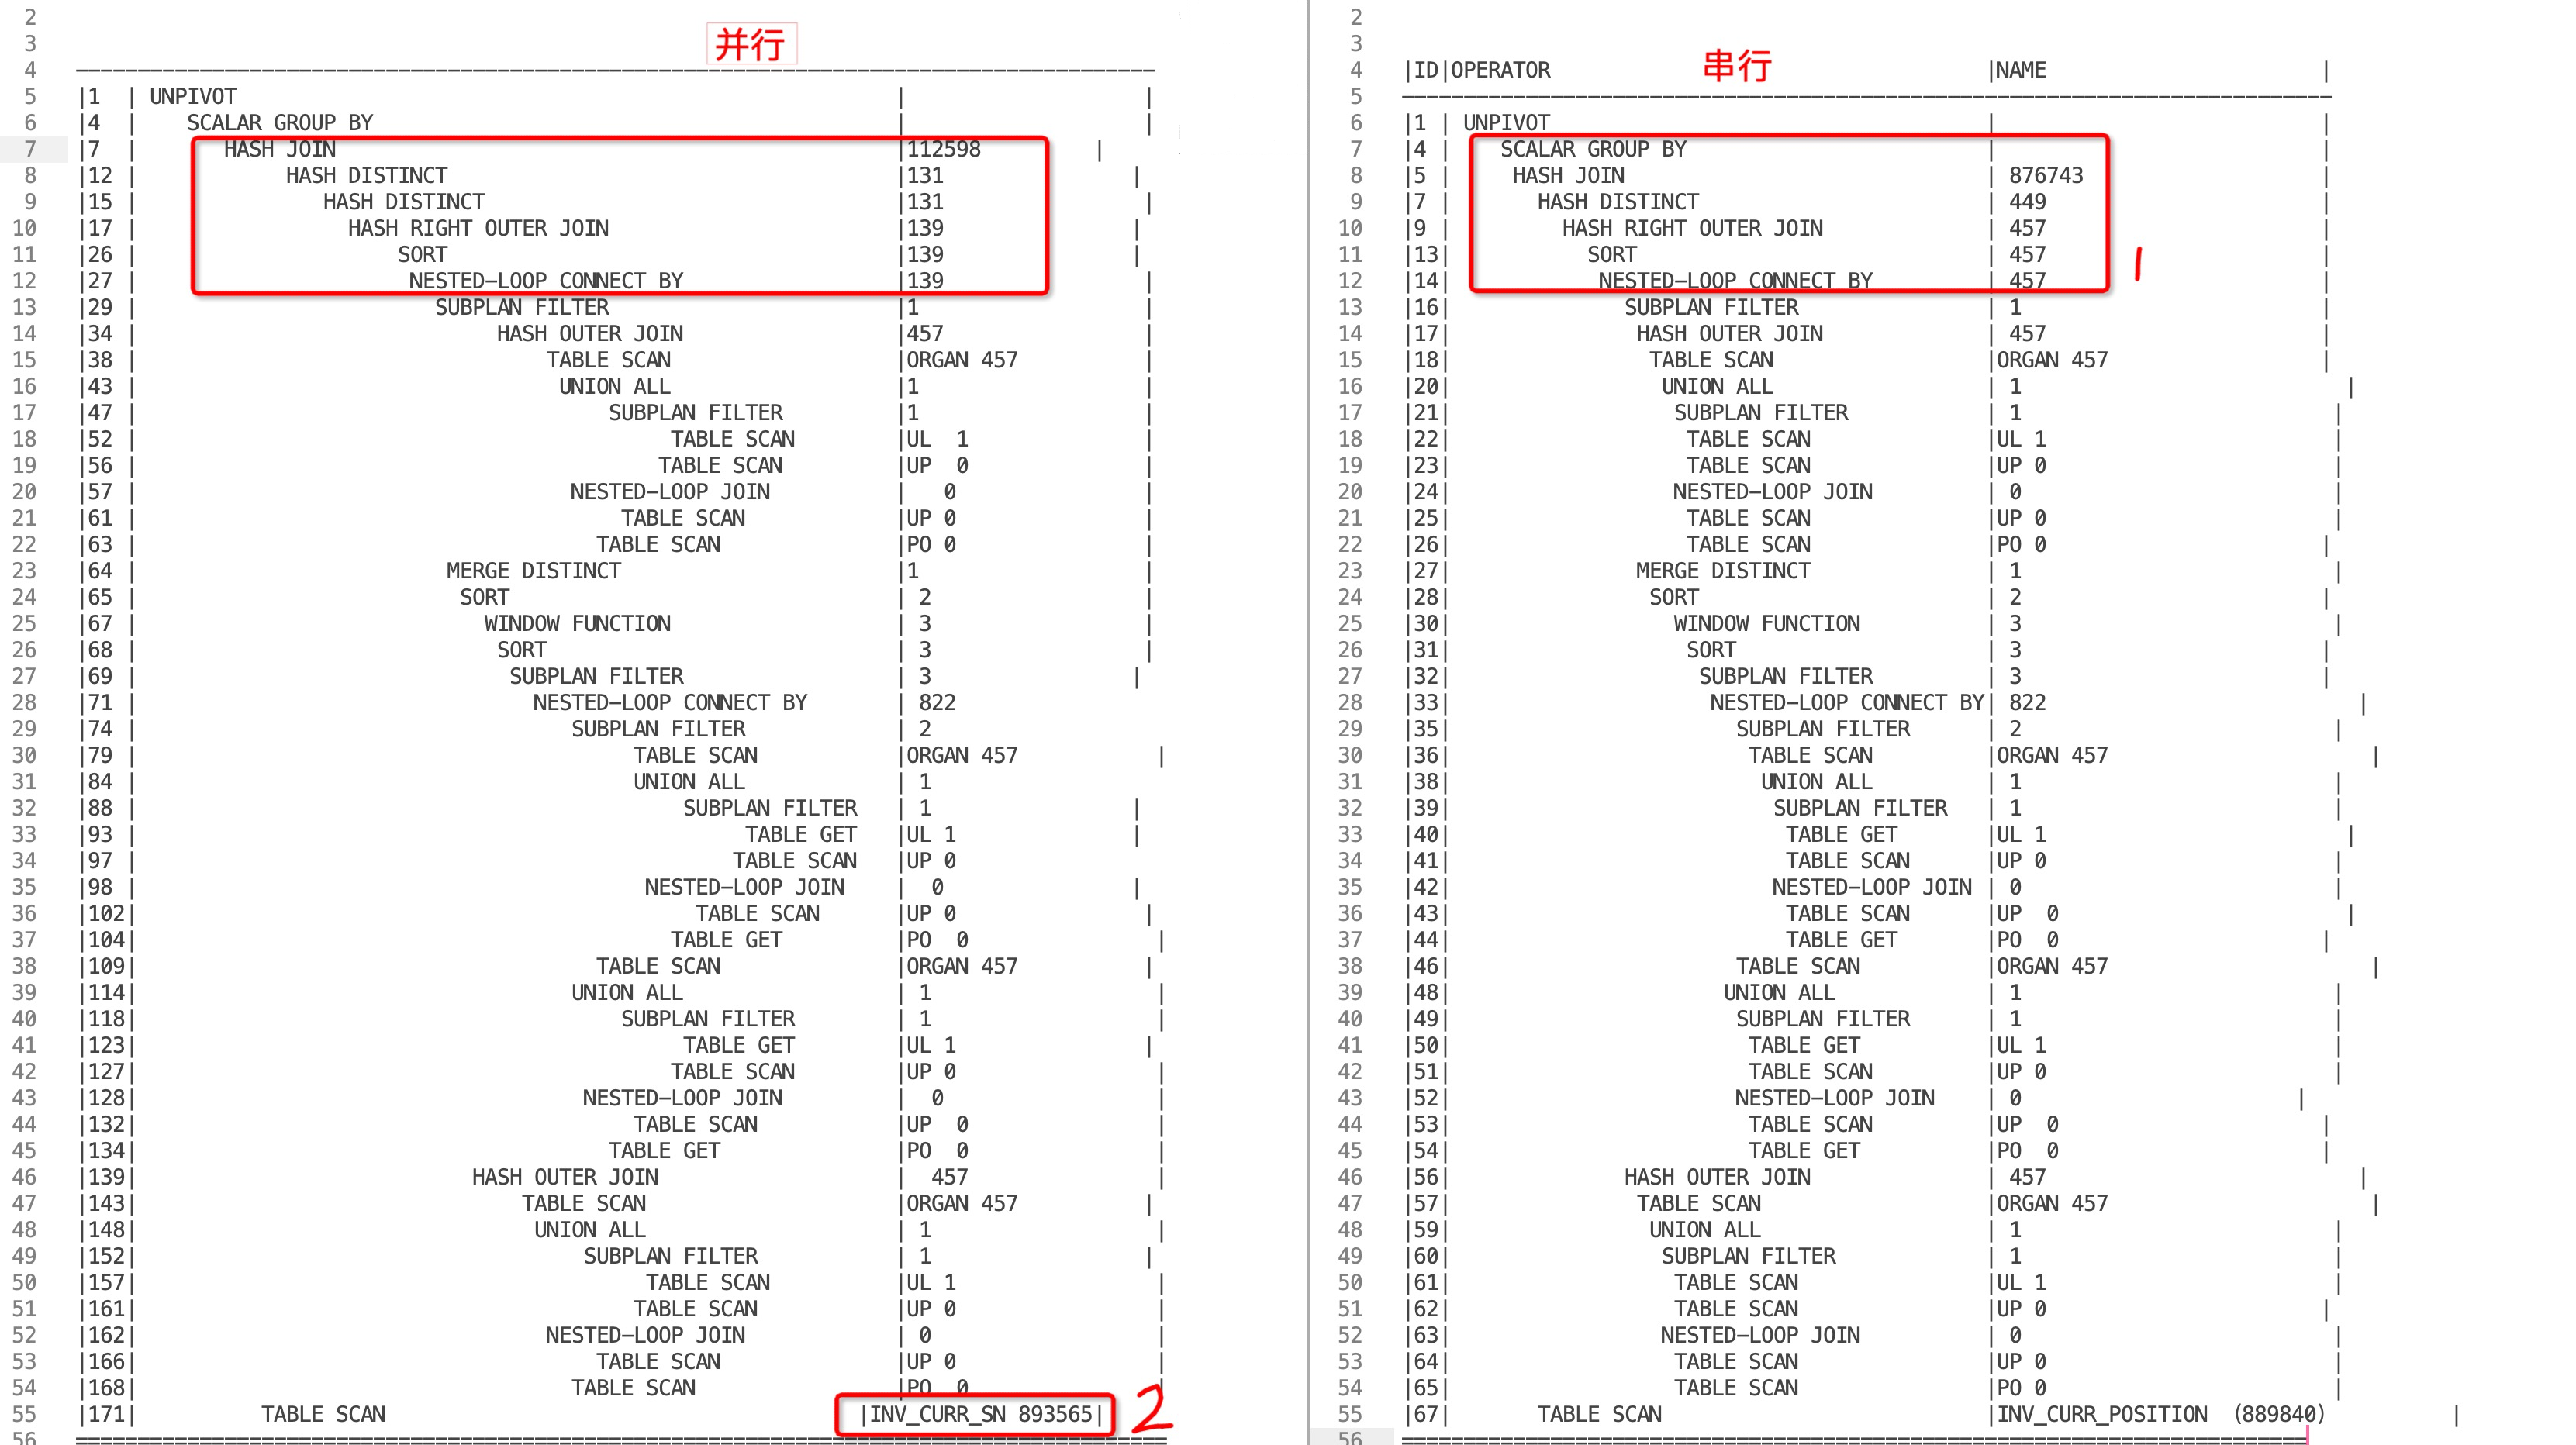
找到不一致的点后,增加 monitor dump 来监控不一致算子的输入有什么不同。对比并行串行结果可知,NESTED-LOOP CONNECT BY吐出的行数不一致。
并行计划中,该算子的两个 child 的 算子 ID 为 28,135:

串行计划中,该算子的两个 child 的 算子 ID 为 15,55:
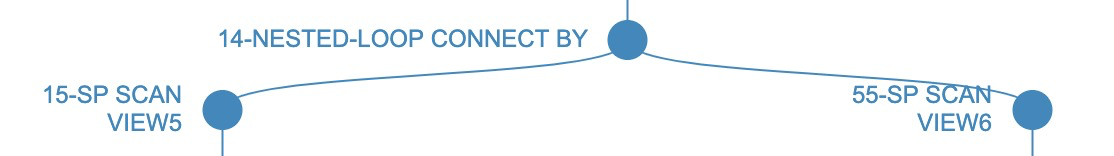
使用 tracing() hint 来获取数据。
步骤三:获取串行与并行执行计划
如果需要 tracing 的行数很多,需要临时关闭日志限流。
在系统租户 SYS 中查看系统日志限流
syslog_io_bandwidth_limit参数值。show parameters like 'syslog_io_bandwidth_limit';设置系统日志所能占用的磁盘 IO 带宽上限值,关闭日志限流。
alter system set syslog_io_bandwidth_limit= '10000MB';
分别对串行 SQL、并行 SQL 执行下述操作。
串行计划。
explain 带 /*+ tracing(15,55) */ hint 的 SQL,把计划保存下来(用来确认 hint 加对地方没有)。
执行带 /*+ tracing(15,55) */ hint 的 SQL,获取 trace_id 的值为 Yxxxxx-yyyy。
通过步骤 2 获取的 trace_id 值,在所有机器上查找相应的日志信息。
grep ob_monitoring_dump.*Yxxxxx-yyyy observer.log.xxxx
并行计划
explain 带 /*+ tracing(28,135) parallel(31) */ hint 的 SQL,把计划保存下来(用来确认 hint 加对地方没有 )。
执行带 /*+ tracing(28,135) parallel(31) */ hint 的 SQL,获取 trace_id 值为 Yxxxxx-yyyy。
通过步骤 2 获取的 trace_id 值,在所有机器上查找相应的日志信息。
grep ob_monitoring_dump.*Yxxxxx-yyyy observer.log.xxxx
注意
- 串行计划、并行计划的 hint 不一样,操作时请注意。
- 获取日志时,要去所有机器上获取。
恢复日志限流。
恢复设置系统日志所能占用的磁盘 IO 带宽上限值默认值 30MB,开启日志限流。
alter system set syslog_io_bandwidth_limit= '30MB';在系统租户 SYS 中查看系统日志限流
syslog_io_bandwidth_limit参数值。show parameters like 'syslog_io_bandwidth_limit';
四、总结
分析获取的行数据,如果串行、并行计划里的 projector 不一样,需要根据 projector 信息对数据做一些重排。然后对数据排序,vimdiff 看排序后的结果,查找不一致的点。
如果完全一致,就不要排序,怀疑软件缺陷和数据输入顺序有关。
使用版本
OceanBase 数据库所有版本。


