
基于湖库一体架构,统一管理结构化、半结构化与非结构化等多模态数据,一个系统承载事务处理、实时分析与 AI 工作负载。


创建物化视图
更新时间:2026-08-30 22:11:55
编辑
分享
本文将向您介绍如何使用 SQL 语句创建物化视图。
说明
OceanBase 数据库暂时不支持直接修改物化视图的属性,如更新时间、刷新策略等。在这种情况下,可以考虑删除并重新创建物化视图以达到修改物化视图的目的。
权限要求
创建物化视图需要有 CREATE TABLE 权限。更多有关 OceanBase 数据库权限的详细介绍,请参见 Oracle 模式下的权限分类。
语法
创建物化视图的 SQL 语句格式如下:
CREATE MATERIALIZED VIEW view_name [([column_list] [PRIMARY KEY(column_list)])]
[table_option_list]
[partition_option]
[mv_column_group_option]
[refresh_clause [PARALLEL n] [query_rewrite_clause] [on_query_computation_clause]]
AS view_select_stmt;
参数说明:
view_name:指定待创建的物化视图的名称。column_list:可选项,指定物化视图的列列表。如果想要为视图列指定明确的名称,可以使用column_list子句,并在其中使用逗号分隔的列名。PRIMARY KEY(column_list):可选项,用于指定物化视图的主键。table_option_list:可选项,指定物化视图的表选项。partition_option:可选项,指定物化视图的分区选项。mv_column_group_option:可选项,指定物化视图的存储格式。不指定时,默认创建行存格式的物化视图。refresh_clause [PARALLEL n] [query_rewrite_clause] [on_query_computation_clause]:可选项,具体如下:refresh_clause:指定物化视图的刷新方式。PARALLEL n:指定刷新并行度。query_rewrite_clause:可选项,指定当前物化视图是否开启自动改写。on_query_computation_clause:可选项,指定当前物化视图是普通物化视图还是实时物化视图。
AS view_select_stmt:用于定义物化视图数据的查询(SELECT)语句。该语句用于从基表中检索数据,并将结果存储到物化视图中。说明
- OceanBase 数据库支持外表作为物化视图的基表来创建全量刷新物化视图。
- OceanBase 数据库支持在创建物化视图时对基表添加
AS OF PROCTIME()子句,若在创建物化视图基表位置之外的地方使用了AS OF PROCTIME()则会报错。AS OF PROCTIME()用于指定增量刷新时跳过这张表的刷新,并且AS OF PROCTIME()的表可以不创建 mlog。 - OceanBase 数据库支持普通视图声明为维度表(
AS OF PROCTIME())时,可以作为增量刷新物化视图的基表。
有关创建物化视图语法的详细参数说明信息,请参见 CREATE MATERIALIZED VIEW。
创建物化视图
创建普通物化视图
创建物化视图时,省略或者指定 DISABLE ON QUERY COMPUTATION 子句创建普通物化视图。
注意
OceanBase 数据库 Oracle 模式下,创建物化视图指定 DISABLE ON QUERY COMPUTATION 子句(on_query_computation_clause)时,必须指定刷新方式(refresh_clause)。
示例如下:
创建表
tbl1作为物化视图的基表。CREATE TABLE tbl1 (col1 NUMBER PRIMARY KEY, col2 VARCHAR2(20), col3 NUMBER);基于表
tbl1创建名为mv_tbl1的物化视图。CREATE MATERIALIZED VIEW mv_tbl1 AS SELECT col1, col2 FROM tbl1 WHERE col3 >= 20;或者
CREATE MATERIALIZED VIEW mv_tbl1 REFRESH FORCE DISABLE ON QUERY COMPUTATION AS SELECT col1, col2 FROM tbl1 WHERE col3 >= 20;
创建嵌套物化视图
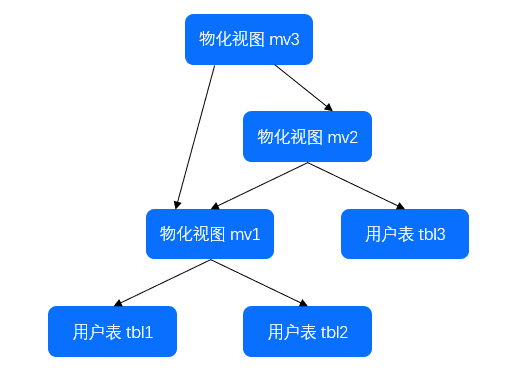
嵌套物化视图就是在已有的物化视图上构建的物化视图。例如下图,物化视图 mv1 基于表 tbl1 和表 tbl2 构建,是典型的物化视图。物化视图 mv2 则基于物化视图 mv1 和表 tbl3 构建,属于是嵌套物化视图。同理,物化视图 mv3 基于物化视图 mv1 和物化视图 mv2 构建,也是嵌套物化视图。
OceanBase 数据库创建嵌套物化视图时支持指定刷新策略,取值如下:
INDIVIDUAL:默认值,表示独立刷新。INCONSISTENT:表示级联非一致性刷。CONSISTENT:表示级联一致性刷新。
说明
对于非嵌套物化视图来说,不存在级联刷新行为,无论指定为何种刷新策略均无意义,都默认独立刷新。指定的三种刷新策略只在后台任务生效,当手动使用 PL 包(DBMS_MVIEW.REFRESH)调度刷新,按照指定的 PL 参数执行刷新。
嵌套物化视图功能限制
- 为了支持嵌套物化视图的增量刷新,需要在物化视图(基表)上创建 mlog。
- 如果一个物化视图进行了全量刷新,那么依赖它的物化视图(嵌套物化视图)在后续进行增量刷新前必须先进行一次全量刷新,否则会报错。
- 嵌套物化视图不支持创建为实时物化视图,即创建嵌套物化视图时不支持指定
ENABLE ON QUERY COMPUTATION子句。
示例如下:
创建表
tbl3作为物化视图的基表。CREATE TABLE tbl3(id INT, name VARCHAR2(30), PRIMARY KEY(id));创建表
tbl4作为物化视图的基表。CREATE TABLE tbl4(id INT, age INT, PRIMARY KEY(id));基于
tbl3和tbl4创建物化视图mv1_tbl3_tbl4。CREATE MATERIALIZED VIEW mv1_tbl3_tbl4 (PRIMARY KEY (id1, id2)) REFRESH COMPLETE AS SELECT tbl3.id id1, tbl4.id id2, tbl3.name, tbl4.age FROM tbl3, tbl4 WHERE tbl3.id = tbl4.id;基于物化视图
mv1_tbl3_tbl4创建物化视图(嵌套物化视图)mv_mv1_tbl3_tbl4。CREATE MATERIALIZED VIEW mv_mv1_tbl3_tbl4 REFRESH COMPLETE AS SELECT SUM(AGE) age_sum FROM mv1_tbl3_tbl4;基于物化视图
mv1_tbl3_tbl4创建物化视图(嵌套物化视图)mv1_mv1_tbl3_tbl4,刷新策略为INCONSISTENT。CREATE MATERIALIZED VIEW mv1_mv1_tbl3_tbl4 REFRESH COMPLETE INCONSISTENT AS SELECT SUM(AGE) age_sum FROM mv1_tbl3_tbl4;
创建实时物化视图
创建物化视图时,指定 ENABLE ON QUERY COMPUTATION 子句创建实时物化视图。
注意
OceanBase 数据库 Oracle 模式下,创建实时物化视图必须指定刷新方式(refresh_clause)。
创建实时物化视图注意事项
在创建实时物化视图前,物化视图依赖的基表都需要创建物化视图日志,OceanBase 数据库支持物化视图日志自动管理功能,默认系统自动创建物化视图日志,详细信息参见 物化视图日志。
只有特定类型的物化视图支持指定为实时物化视图,对于不满足条件的物化视图指定实时物化视图时,会导致报错。实时物化视图的要求与增量刷新的物化视图要求是相同的。详细信息,参见 刷新物化视图 中 增量刷新基本要求 内容。
- 使用
MIN/MAX函数的物化视图不支持实时物化视图。 - 带有外连接的聚合物化视图不支持实时物化视图。
- 带有集合查询的物化视图不支持实时物化视图。
- 嵌套物化视图不支持创建为实时物化视图。
- 使用
当执行查询的 Session 上的系统变量值和创建物化视图时固化在物化视图中的 Session 变量不一致时,需要将 Session 上的系统变量值修改为实时物化视图中固化的 Session 变量值,否则实时物化视图不可用,即实时物化视图查询改写不生效或直接查询实时物化视图会报错。
示例如下:
创建表
tbl2作为物化视图的基表。CREATE TABLE tbl2(col1 INT, col2 INT, col3 INT);基于表
tbl2创建实时物化视图mv_tbl2。CREATE MATERIALIZED VIEW mv_tbl2 REFRESH COMPLETE ON DEMAND ENABLE ON QUERY COMPUTATION AS SELECT col1, count(*) AS cnt FROM tbl2 GROUP BY col1;创建实时物化视图后,可以通过视图 DBA_MVIEWS 查看物化视图的定位是否为实时物化视图。
SELECT MVIEW_NAME, ON_QUERY_COMPUTATION FROM sys.DBA_MVIEWS WHERE MVIEW_NAME = 'MV_TBL2';注意
Oracle 模式中视图
sys.DBA_MVIEWS中字段MVIEW_NAME匹配表名时,表名需使用大写字母。返回结果如下:
+------------+----------------------+ | MVIEW_NAME | ON_QUERY_COMPUTATION | +------------+----------------------+ | MV_TBL2 | Y | +------------+----------------------+ 1 row in set查看实时物化视图的执行计划。
EXPLAIN BASIC SELECT * FROM mv_tbl2;从下面的执行计划中可以看到,执行期间会同时从物化视图和视图依赖基表的 mlog 读取数据,并对这两部分数据进行计算整合,最终获取实时的物化视图数据。
返回结果如下:
+----------------------------------------------------------------------------------------------------------------------------------------------------------------------------------+ | Query Plan | +----------------------------------------------------------------------------------------------------------------------------------------------------------------------------------+ | ============================================== | | |ID|OPERATOR |NAME | | | ---------------------------------------------- | | |0 |HASH GROUP BY | | | | |1 |└─SUBPLAN SCAN |INNER_RT_MV$$| | | |2 | └─UNION ALL | | | | |3 | ├─TABLE FULL SCAN |MV_TBL2 | | | |4 | └─HASH GROUP BY | | | | |5 | └─SUBPLAN SCAN |DLT_T$$ | | | |6 | └─WINDOW FUNCTION | | | | |7 | └─TABLE FULL SCAN|MLOG$_TBL2 | | | ============================================== | | Outputs & filters: | | ------------------------------------- | | 0 - output([INNER_RT_MV$$.COL1], [cast(T_FUN_SUM(INNER_RT_MV$$.CNT), NUMBER(38, 0))]), filter([T_FUN_SUM(INNER_RT_MV$$.CNT) > cast(0, NUMBER(-1, -85))]), rowset=16 | | group([INNER_RT_MV$$.COL1]), agg_func([T_FUN_SUM(INNER_RT_MV$$.CNT)]) | | 1 - output([INNER_RT_MV$$.COL1], [INNER_RT_MV$$.CNT]), filter(nil), rowset=16 | | access([INNER_RT_MV$$.COL1], [INNER_RT_MV$$.CNT]) | | 2 - output([UNION([1])], [UNION([2])]), filter(nil), rowset=16 | | 3 - output([MV_TBL2.COL1], [MV_TBL2.CNT]), filter(nil), rowset=16 | | access([MV_TBL2.COL1], [MV_TBL2.CNT]), partitions(p0) | | is_index_back=false, is_global_index=false, | | range_key([MV_TBL2.__pk_increment]), range(MIN ; MAX)always true | | 4 - output([DLT_T$$.COL1], [T_FUN_SUM(CASE WHEN DLT_T$$.OLD_NEW$$ = cast('N', VARCHAR2(1048576 )) THEN cast(1, NUMBER(-1, -85)) ELSE (T_OP_NEG, cast(1, | | NUMBER(-1, -85))) END)]), filter(nil), rowset=16 | | group([DLT_T$$.COL1]), agg_func([T_FUN_SUM(CASE WHEN DLT_T$$.OLD_NEW$$ = cast('N', VARCHAR2(1048576 )) THEN cast(1, NUMBER(-1, -85)) ELSE (T_OP_NEG, | | cast(1, NUMBER(-1, -85))) END)]) | | 5 - output([DLT_T$$.OLD_NEW$$], [DLT_T$$.COL1]), filter([DLT_T$$.OLD_NEW$$ = cast('N', VARCHAR2(1048576 )) AND DLT_T$$.SEQUENCE$$ = DLT_T$$.MAXSEQ$$ OR | | DLT_T$$.OLD_NEW$$ = cast('O', VARCHAR2(1048576 )) AND DLT_T$$.SEQUENCE$$ = DLT_T$$.MINSEQ$$]), rowset=16 | | access([DLT_T$$.OLD_NEW$$], [DLT_T$$.SEQUENCE$$], [DLT_T$$.MAXSEQ$$], [DLT_T$$.MINSEQ$$], [DLT_T$$.COL1]) | | 6 - output([MLOG$_TBL2.OLD_NEW$$], [MLOG$_TBL2.SEQUENCE$$], [T_FUN_MAX(MLOG$_TBL2.SEQUENCE$$)], [T_FUN_MIN(MLOG$_TBL2.SEQUENCE$$)], [MLOG$_TBL2.COL1]), filter(nil), rowset=16 | | win_expr(T_FUN_MAX(MLOG$_TBL2.SEQUENCE$$)), partition_by([MLOG$_TBL2.M_ROW$$]), order_by(nil), window_type(RANGE), upper(UNBOUNDED PRECEDING), lower(UNBOUNDED | | FOLLOWING) | | win_expr(T_FUN_MIN(MLOG$_TBL2.SEQUENCE$$)), partition_by([MLOG$_TBL2.M_ROW$$]), order_by(nil), window_type(RANGE), upper(UNBOUNDED PRECEDING), lower(UNBOUNDED | | FOLLOWING) | | 7 - output([MLOG$_TBL2.M_ROW$$], [MLOG$_TBL2.SEQUENCE$$], [MLOG$_TBL2.OLD_NEW$$], [MLOG$_TBL2.COL1], [ORA_ROWSCN]), filter([cast(ORA_ROWSCN, NUMBER(-1, | | -1)) > last_refresh_scn(500155)]), rowset=16 | | access([MLOG$_TBL2.M_ROW$$], [MLOG$_TBL2.SEQUENCE$$], [MLOG$_TBL2.OLD_NEW$$], [MLOG$_TBL2.COL1], [ORA_ROWSCN]), partitions(p0) | | is_index_back=false, is_global_index=false, filter_before_indexback[false], | | range_key([MLOG$_TBL2.M_ROW$$], [MLOG$_TBL2.SEQUENCE$$]), range(MIN,MIN ; MAX,MAX)always true | +----------------------------------------------------------------------------------------------------------------------------------------------------------------------------------+ 40 rows in set
创建开启查询改写的物化视图
创建物化视图时,指定 ENABLE QUERY REWRITE 子句开启当前物化视图的自动改写。更多物化视图改写和改写控制的信息,参见 物化视图查询改写。
注意
对于定义了 ENABLE QUERY REWRITE 子句的物化视图并不表示物化视图一定会改写查询。对于不满足查询改写条件的物化视图,不会报错,但不会被用于改写。由于系统变量 query_rewrite_enabled 默认值是 false,所以默认情况下定义了 ENABLE QUERY REWRITE 子句的物化视图并不会被用于改写。
示例如下:
基于表
tbl1创建物化视图mv_spj_tbl1,并开启自动改写。CREATE MATERIALIZED VIEW mv_spj_tbl1 NEVER REFRESH ENABLE QUERY REWRITE AS SELECT * FROM tbl1;创建物化视图后,可以通过视图 DBA_MVIEWS 查看物化视图是否开启自动改写。
SELECT MVIEW_NAME, REWRITE_ENABLED FROM sys.DBA_MVIEWS WHERE MVIEW_NAME = 'MV_SPJ_TBL1';注意
Oracle 模式中视图
sys.DBA_MVIEWS中字段MVIEW_NAME匹配表名时,表名需使用大写字母。返回结果如下:
+-------------+-----------------+ | MVIEW_NAME | REWRITE_ENABLED | +-------------+-----------------+ | MV_SPJ_TBL1 | Y | +-------------+-----------------+ 1 row in set
创建列存格式物化视图
OceanBase 数据库支持行存、列存和行存列存冗余格式的物化视图,可以通过指定 mv_column_group_option 选项来显示创建列存或者行存列存冗余格式的物化视图。如果物化视图是多表 JOIN 形成的一张大宽表,创建列存格式的物化视图可以提高某些查询的性能。通过指定 WITH COLUMN GROUP(each column) 创建列存格式的物化视图。
说明
不指定 mv_column_group_option 选项时,默认创建行存格式的物化视图。
示例如下:
基于表 tbl1 创建列存格式的物化视图 mv_ec_tbl1。
CREATE MATERIALIZED VIEW mv_ec_tbl1
WITH COLUMN GROUP(each column)
AS SELECT *
FROM tbl1;
创建物化视图时添加主键
注意
为物化视图指定主键后,维护/更新物化视图数据时,如果数据不满足主键约束,将导致视图维护失败。
示例如下:
基于表 tbl1 创建名为 mv_pk_tbl1 的物化视图,并指定主键。
CREATE MATERIALIZED VIEW mv_pk_tbl1(v_id, v_name, PRIMARY KEY(v_id))
AS SELECT col1, col2
FROM tbl1
WHERE col3 >= 20;
创建物化视图时添加表选项和分区选项
在创建物化视图时,可以设置表选项,并根据数据特征和访问模式来设计和配置适合的分区选项,以提高查询性能和管理效率。
有关表选项和分区选项的详细参数说明信息,请参见 CREATE TABLE。
示例如下:
基于表 tbl1 创建名为 mv_pp_tbl1 的物化视图,指定物化视图的并行度为 5,将物化视图按照 col1 列进行 Hash 分区,并分为 8 个分区;将 tbl1 表中满足条件 col3 >= 20 的记录作为基表进行查询,并将查询结果作为物化视图的数据。
CREATE MATERIALIZED VIEW mv_pp_tbl1
PARALLEL 5
PARTITION BY HASH(col1) PARTITIONS 8
AS SELECT col1, col2
FROM tbl1
WHERE col3 >= 20;
物化视图添加索引
在创建物化视图的语句中,不能直接创建索引,但可以使用 CREATE INDEX 语句为物化视图创建索引。
示例如下:
在物化视图 mv_tbl1 的 col1 列上创建名为 idx_mv_tbl1 的索引。
CREATE INDEX idx_mv_tbl1 ON mv_tbl1(col1);
物化视图刷新
OceanBase 数据库物化视图支持全量刷新、增量刷新、混合刷新和永不刷新四种刷新策略。具体如下:
- 全量刷新:重新计算整个物化视图的数据,确保视图中的数据与源表完全一致。
- 增量刷新:只刷新与源表变化相关的数据,避免对整个视图进行完全计算。
- 混合刷新:默认选项,首先尝试增量刷新,如果增量刷新失败,则执行全量刷新。
- 永不刷新:物化视图只在创建时进行刷新,并在创建后不允许再次刷新。
更多物化视图刷新的信息,请参见 刷新物化视图。
创建全量刷新物化视图
创建物化视图时,使用 REFRESH COMPLETE 子句设置物化视图的刷新策略为全量刷新。
注意
如果一个物化视图进行了全量刷新,那么依赖它的物化视图(嵌套物化视图)在后续进行增量刷新前必须先进行一次全量刷新,否则会报错。
示例如下:
基于表 tbl1 创建名为 mv_rc_tbl1 的物化视图,指定物化视图的刷新策略为全量刷新(REFRESH COMPLETE),指定从 tbl1 表中选择满足 col3 大于等于 20 的 col1 和 col2 列作为物化视图的数据源。
CREATE MATERIALIZED VIEW mv_rc_tbl1
REFRESH COMPLETE
AS SELECT col1, col2
FROM tbl1
WHERE col3 >= 20;
基于外表创建全量刷新物化视图
OceanBase 数据库支持外表作为物化视图的基表来创建全量刷新物化视图。
有关外表的介绍信息,参见 关于外表。
示例如下:
注意
示例中涉及 IP 的命令做了脱敏处理,在验证时应根据自己机器真实 IP 填写。
以下将以外部文件的位置在本地和在 OceanBase 数据库 Oracle 模式中创建外表为例,步骤如下:
准备外部文件。
执行以下命令,在要登录 OBServer 节点所在机器的
/home/admin/external_csv目录下,创建文件ext_tbl1.csv。[admin@xxx /home/admin/external_csv]# vi ext_tbl1.csv文件的内容如下:
1,'A1' 2,'A2' 3,'A3'设置导入的文件路径。
注意
由于安全原因,设置系统变量
secure_file_priv时,只能通过本地 Socket 连接数据库执行修改该全局变量的 SQL 语句。更多信息,请参见 secure_file_priv。执行以下命令,登录到 OBServer 节点所在的机器。
ssh admin@10.10.10.1执行以下命令,通过本地 Unix Socket 连接方式连接租户
oracle001。obclient -S /home/admin/oceanbase/run/sql.sock -usys@oracle001 -p******执行以下 SQL 命令,设置导入路径为
/home/admin/external_csv。SET GLOBAL secure_file_priv = "/home/admin/external_csv";
重新连接租户
oracle001。示例如下:
obclient -h10.10.10.1 -P2881 -usys@oracle001 -p****** -A创建外表
ext_tbl1。CREATE EXTERNAL TABLE ext_tbl1 ( id INT, name VARCHAR2(50) ) LOCATION = '/home/admin/external_csv' FORMAT = ( TYPE = 'CSV' FIELD_DELIMITER = ',' FIELD_OPTIONALLY_ENCLOSED_BY ='''' ) PATTERN = 'ext_tbl1.csv';基于外表
ext_tbl1创建全量刷新物化视图mv_ext_tbl1。CREATE MATERIALIZED VIEW mv_ext_tbl1 REFRESH COMPLETE AS SELECT * FROM ext_tbl1;查看物化视图
mv_ext_tbl1数据。SELECT * FROM mv_ext_tbl1;返回结果如下:
+------+------+ | ID | NAME | +------+------+ | 2 | A2 | | 1 | A1 | | 3 | A3 | +------+------+ 3 rows in set
创建增量刷新物化视图
创建物化视图时,使用 REFRESH FAST 子句设置物化视图的刷新策略为增量刷新。
创建增量刷新物化视图注意事项
增量刷新的物化视图目前支持单表非聚合、单表聚合、多表关联、多表关联聚合、集合查询(
UNION ALL)的 SQL 语句,对于不满足这五类场景的 SQL 语句,暂不支持增量刷新,增量刷新 SQL 语句要求详见 刷新物化视图 中 增量刷新 章节。REFRESH FAST方法利用物化视图日志中的记录信息来确定需要增量刷新的内容,OceanBase 数据库支持物化视图日志自动管理功能,默认系统自动创建物化视图日志,详细信息参见 物化视图日志。在创建物化视图时,可以对基表添加
AS OF PROCTIME()子句,若在基表位置之外的地方使用了AS OF PROCTIME()则会报错。AS OF PROCTIME()用于指定增量刷新时跳过这张表的刷新,来加速物化视图的增量刷新。并且AS OF PROCTIME()的表可以不创建 mlog。如果该表需要使用别名,表别名需放在AS OF PROCTIME()子句后面。使用普通视图声明为维度表(
AS OF PROCTIME())作为增量刷新物化视图的基表时,有如下限制:- 与基表的维度表类似,不允许物化视图中使用的所有表都为维度表。
示例如下:
创建表
tbl5作为物化视图的基表。CREATE TABLE tbl5 (col1 INT PRIMARY KEY, col2 INT, col3 INT);基于表
tbl5创建名为mv_tbl5的物化视图,指定物化视图的刷新策略为增量刷新(REFRESH FAST),在查询部分指定从tbl5表中按照col2列进行分组,并计算col3列的总和(sum_col3)作为物化视图的结果。CREATE MATERIALIZED VIEW mv_tbl5 REFRESH FAST AS SELECT col2, SUM(col3) sum_col3 FROM tbl5 GROUP BY col2;基于表
tbl5和tbl1创建名为mv2_tbl5_tbl1的物化视图,指定物化视图的刷新策略为增量刷新,通过col1字段进行内连接(INNER JOIN)。使用AS OF PROCTIME()指定表tbl1在物化视图增量刷新时需要跳过此表。CREATE MATERIALIZED VIEW mv2_tbl5_tbl1 REFRESH FAST ON DEMAND AS SELECT t5.col1 tbl5_c1, t1.col1 tbl1_c1, t5.col2 tbl5_c2, t1.col2 tbl1_c2 FROM tbl5 t5 INNER JOIN tbl1 AS OF PROCTIME() t1 ON t5.col1 = t1.col1 WHERE t5.col2 = 3;基于引用声明为
AS OF PROCTIME()的普通视图创建增量刷新物化视图。基于表
tbl5创建视图v1_tbl5。obclient> CREATE VIEW v1_tbl5 AS SELECT * FROM tbl5;基于表
tbl5和v1_tbl5创建名为mv3_tbl5_v_tbl5的物化视图,指定物化视图的刷新策略为增量刷新,通过col1字段进行连接。使用AS OF PROCTIME()指定视图v1_tbl5为维度表。obclient> CREATE MATERIALIZED VIEW mv3_tbl5_v_tbl5 AS SELECT a.col1 a_c1, b.col1 b_c1 FROM tbl5 a JOIN v1_tbl5 AS OF PROCTIME() b ON a.col1 = b.col1;
创建混合刷新物化视图(默认选项)
创建物化视图时,省略或者指定 REFRESH FORCE 子句设置物化视图的刷新策略为混合刷新。
示例如下:
基于表 tbl1 创建名为 mv_rf_tbl1 的物化视图,指定物化视图的刷新策略为混合刷新(REFRESH FORCE),指定从 tbl1 表中选择满足 col3 大于等于 20 的 col1 和 col2 列作为物化视图的数据源。
CREATE MATERIALIZED VIEW mv_rf_tbl1
REFRESH FORCE
AS SELECT col1, col2
FROM tbl1
WHERE col3 >= 20;
创建物化视图时指定刷新并行度
创建物化视图时,通过 REFRESH ... PARALLEL n 指定刷新并行度。
示例如下:
基于表 tbl1 创建名为 mv_rcp3_tbl1 的物化视图,指定物化视图的刷新策略为全量刷新(REFRESH COMPLETE),并且指定查询并行度为 16 及刷新并行度为 5,从 tbl1 表中选择满足 col3 大于等于 20 的 col1 和 col2 列作为物化视图的数据源。
obclient> CREATE MATERIALIZED VIEW mv_rcp3_tbl1
PARALLEL 16
REFRESH COMPLETE PARALLEL 5 ON DEMAND
AS SELECT col1, col2
FROM tbl1
WHERE col3 >= 20;
创建永不刷新物化视图
创建物化视图时,使用 NEVER REFRESH 子句设置物化视图不需要刷新。即表示物化视图只在创建时进行刷新,并在创建后不允许再次刷新。
示例如下:
基于表 tbl1 创建名为 mv_nr_tbl1 的物化视图,指定物化视图的刷新策略为永不刷新(NEVER REFRESH),指定从 tbl1 表中选择满足 col3 大于等于 20 的 col1 和 col2 列作为物化视图的数据源。
CREATE MATERIALIZED VIEW mv_nr_tbl1
NEVER REFRESH
AS SELECT col1, col2
FROM tbl1
WHERE col3 >= 20;
创建自动刷新物化视图
在创建物化视图时,可以通过指定 START WITH datetime_expr 和 NEXT datetime_expr 子句来为物化视图创建一个后台自动刷新任务。
注意
如果使用了 NEXT 子句,刷新计划的时间表达式必须设定在未来的时间点,否则会引发错误。
示例如下:
基于表 tbl1 创建名为 mv_rc_swn_tbl1 的物化视图,指定物化视图的刷新策略为全量刷新,物化视图的刷新计划中初始刷新时间为当前日期,之后每隔 1 小时刷新一次物化视图。
CREATE MATERIALIZED VIEW mv_rc_swn_tbl1
REFRESH COMPLETE
START WITH current_date NEXT current_date + INTERVAL '1' HOUR
AS SELECT col1, col2
FROM tbl1
WHERE col3 >= 20;


