
基于湖库一体架构,统一管理结构化、半结构化与非结构化等多模态数据,一个系统承载事务处理、实时分析与 AI 工作负载。


划线反馈
OceanBase 数据库多租户线程
更新时间:2026-06-23 08:06
分享
适用版本:V2.1.x、V2.2.x、V3.1.x、V3.2.x内容类型:FAQ
本节主要介绍了 OceanBase 数据库多租户线程的实现原理以及多租户线程相关的一些常见问题。
OceanBase 数据库是一个支持多租户架构的分布式数据库。当 OBServer 在处理来自不同租户的的请求时,需要依靠租户独有的线程进行请求处理,最终返回给客户端(例如,obclient 或者是由应用端通过 OBProxy 返回的结果)。在这个过程中,OceanBase 数据库的后台系统线程运行着系统任务和多租户共享任务。所有的线程的健康运行为 OBServer 的稳定运行以及可靠高可用的数据服务提供基础支撑。为了便于解释 OceanBase 数据库是如何在多租户线程架构下进行请求处理的,我们对 OBServer 收到的三类基本的租户请求进行了详细地介绍。
场景 1:
当 OBServer 收到客户端对租户 A(租户 ID 为 1014)的 SQL 请求,该 SQL 本身是一个 OLTP 型 SQL,只需要由一个租户线程的本地执行就可以完成。请求被执行过程如下:
客户端发起请求 req1 至 OBServer。
req1 进入到租户请求队列,在 OBServer 中,此类 SQL 请求会进入到租户请求队列的 queue4。
多租户的工作线程会巡检请求队列,当租户
1014的租户线程( TNT_1014)发现队列中有需要处理的新线程,将 req1 从队列中取出。TNT_1014 进行对 req1 的执行。
TNT_1014 将执行的结果和返回值返回客户端。
OceanBase 数据库多租户线程处理本地 OLTP 型 SQL 的过程如下图所示。

场景 2:
当 OBServer 收到来自租户 B(租户 ID 为 1011)的另一台 OBServer 的发来的 RPC 请求(例如,分布式的 OLTP 型 SQL请求),该请求需要由该租户线程进行执行。这个 RPC 请求被执行的过程如下:
租户中另一个 OBServer 作为 RPC 客户端发起 RPC 请求 req1 至当前的 OBServer。
req1 回一个 OLTP 的 SQL请求,req1 请求进入到 OBServer 的租户请求队列 queue2。
多租户的工作线程会巡检请求队列,当租户
1011的租户线程(TNT_1011)发现队列中有需要处理的新请求,将 req1 从队列中取出。TNT_1011 进行对 req1 的执行。
TNT_1011 将执行的结果和返回值返回给远端的 OBServer。
OceanBase 数据库多租户线程处理分布式 SQL RPC 请求的过程如下图所示。

场景 3:
当 OBServer 收到客户端对租户 C(租户 ID 为 1013)的 PX SQL 请求,且所有的 SQL 访问都在本地执行。请求被执行的过程如下:
客户端发起请求 req1至 OBServer。
req1 进入到租户请求队列,在 OceanBase 数据库中,普通 SQL 会进入到租户请求队列的 queue4。
多租户的工作线程会巡检请求队列,当租户
1013的租户线程(TNT_1013)发现队列中有需要处理的新线程,将 req1 从队列中取出。租户线程会作为 Local Scheduler 驱动 PX 线程执行任务。
执行完后,将 req1 的执行的结果和返回值返回客户端。
OceanBase 数据库多租户线程处理本地 PX SQL 请求的过程如下图所示。
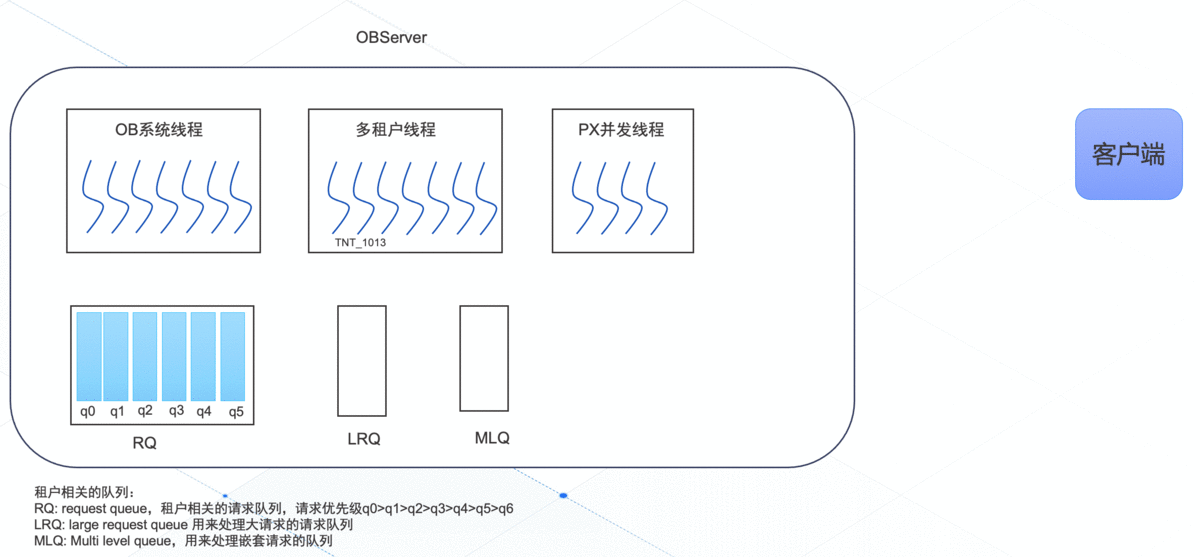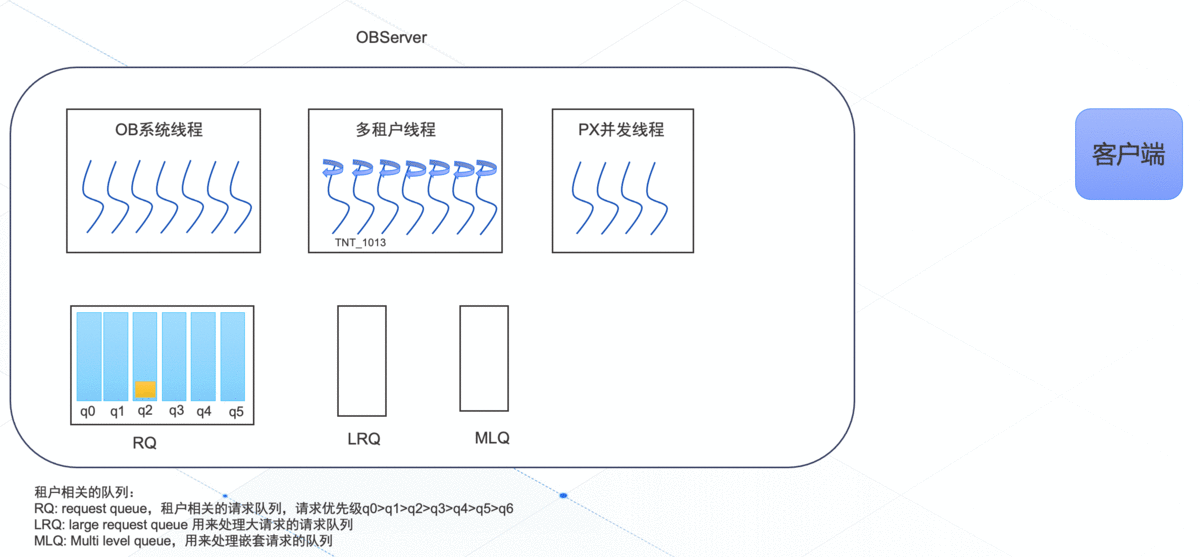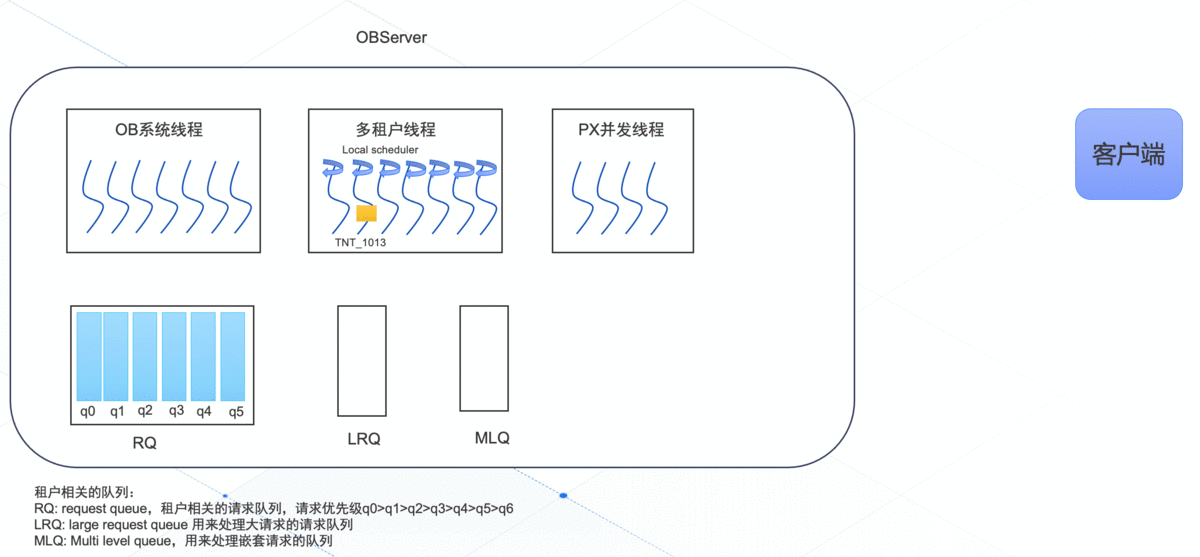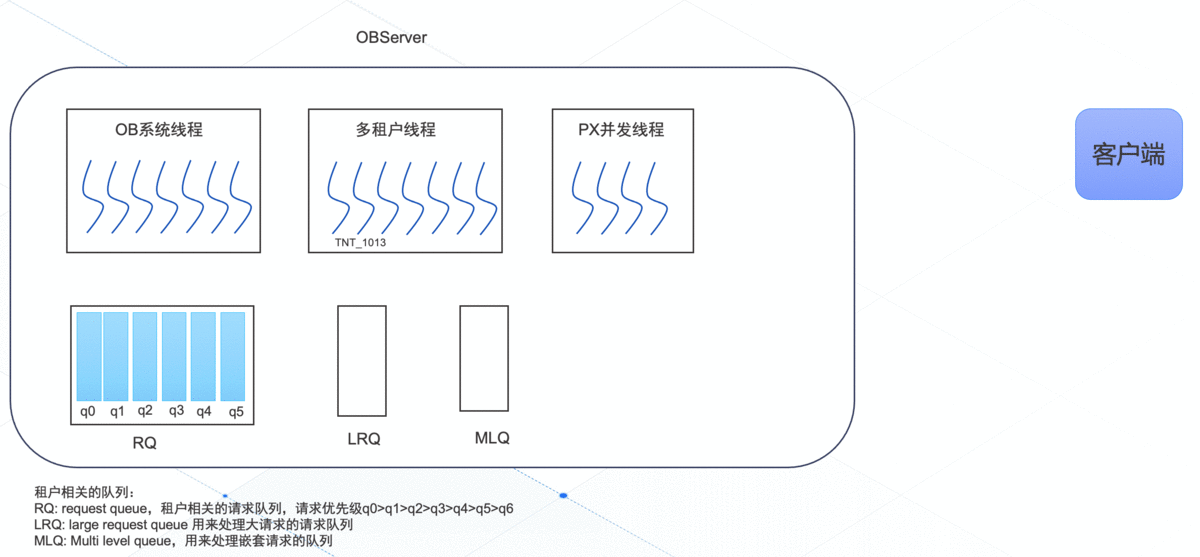
相关参数
| 参数名 | 描述 | 默认值 | 取值范围 | 动态生效 | 推荐值 |
|---|---|---|---|---|---|
| cpu_quota_concurrency | Unit 的参数 min_cpu 和系统配置项 cpu_quota_concurrency 共同决定单个租户活跃线程数。 单个租户活跃线程数 = min_cpu * cpu_quota_concurrency |
4 | [1,10] | 是 | 在标准生产部署下,保持默认值。 |
| workers_per_cpu_quota | Unit 的参数 max_cpu 和系统配置项 workers_per_cpu_quota 共同决定单个租户可分配的线程数上限。 单个租户线程数上限 = max_cpu * workers_per_cpu_quota |
10 | [2, 20] | 是 | 在标准生产部署下,保持默认值。 |
相关视图或系统表
| 视图名或表名 | 描述 |
|---|---|
| __all_virtual_dump_tenant_info | OceanBase 数据库多租户线程中队列和线程限额相关的信息。 |
1.OceanBase 数据库都有哪些线程, 分别是做什么用的?
在 OceanBase 数据库中,有一部分线程是用于维持 OceanBase 数据库分布式数据库服务的系统线程,还有一部分是用来处理数据库负载的 Worker 线程。
整体上,OceanBase 数据库的线程可以分成以下几类:
租户线程:负责租户请求处理的线程,例如,租户处理 SQL 和事务请求的线程, 命名规则为
TNT_L<n>_<tenant id>。系统线程:
net io:处理网络 IO 的线程。
disk io:处理磁盘 IO 的线程。
dag 线程:用于 Partition 的转储、合并、迁移等任务的执行。
clog writer:写 Clog 的线程。
election worker:选举线程。
misc timer:包括多个后台定时器线程,主要负责清理资源。
除此之外,还有一批 RootServer 专有的线程,这里不再做细分。
最后还有一些特定用途的后台线程,在进一步深入了解 OceanBase 数据库之前,可以先忽略。
其中,租户线程是每个租户独有负责执行该租户的请求;系统线程负责保证这一节点上 OBServer 的正常运行、请求处理,是多租户共享的。
2.OceanBase 数据库租户工作线程的线程名字是什么, OceanBase 数据库是如何分配工作线程的数量的?
OceanBase 数据库支持多租户,每个租户都有一个唯一的 ID,租户 ID 是创建租户的时候分配的。每个租户的工作线程都是独立的,ID 为 1001 的租户,它的工作线程的名字是 TNT_L0_1001 ,其中:
TNT:表示租户线程。
L0:表示处理嵌套层级为 0 请求的线程。
1001:租户 ID。
其它租户以此类推。
OceanBase 数据库在启动之后就会把需要的线程创建好,之后除非调整配置项,否则线程数基本不会再变化。某个租户在特定 OBServer 上的 SQL/Transaction Worker 的线程数是由租户的 Unit 规格决定的,其它的线程则是由对应配置项指定的。
3.OceanBase 数据库有哪些后台线程,主要是做什么用的?
下表中列出了OceanBase 数据库的一部分后台线程,并简单解释了这些后台线程的基本功能。在大部分场景下,用户完全不需要去关注后台线程的实现细节。
注意
在 OceanBase 数据库的版本迭代中,有可能会对后台线程进行持续优化和效率提高,因此有些后台线程会在版本升级的过程出现消失、合并的情况;也有可能随着版本的更新,出现新的后台线程。
| 线程名 | 归属模块 | 线程数量 | 功能 |
|---|---|---|---|
| TsMgr | Trx | 1 | 用于本地 GTS Cache 的刷新。 |
| WeakReadSvr | Trx | 1 | 用于计算本地 Server 级别备机读时间戳; |
| HAGtsSource | Trx | 1 | 用于 ha_gts 的刷新,刷新频率由配置项 gts_refresh_interval 控制。 |
| TransCheckpoint Worker | Trx | 1 | 用户事务的 Checkpoint操作。 |
| GCPartAdpt | Trx | 1 | 定期检查 all_tenant_gc_partition_info 表,获取分区的 GC 情况,用于 GC 和事务 2PC 的推进。 |
| PartWorker | Trx | 1 | 遍历本机所有的 Partition,执行以下操作: 1. 每隔 50ms 尝试写事务层 Checkpoint Log。 2. 每隔 15s 计算迁移的快照点。 3. 每隔 10s 驱动本 Partition 上所有活跃事务,为其检查Scheduler 的状态,用于事务上下文的 GC。 4. 每隔 10s 检查该 Partition 复制表的状态。 5. 每隔 10s 驱动刷新本 Partition 上缓存的 Clog日志。 |
| LockWaitMgr | Trx | 1 | 用于热点行场景下,等锁队列兜底的唤醒保障,例如,语句超时、Session 被Kill 等。 |
| ClogAdapter | Trx | 8 | 用于事务层异步提交 Clog。 |
| ObTransService | Trx | 6 | 主要负责以下功能: * 用于事务提交过程处理 Error Message。 * 用于语句回滚失败之后的重试。 * 用于提前解行锁场景,后继事务的唤醒操作。 |
| GCCollector | storage | 1 | 用于定期检查本机所有 Partition 是否能够 GC,如果可以则触发 GC动作。 |
| RebuildSche | storage | 1 | 定期驱动需要 Rebuild 的 Partition 任务。 |
| PurgeWorker | stroage | 1 | 后台 MemTable 的标记删除操作。 |
| DAG | storage | 16 | Dag 的工作线程,用于 Partition 的转储、合并、迁移等任务的执行。 |
| DagScheduler | storage | 1 | Dag 的调度线程。 |
| STableChecksumUp | storage | 1 | 用来批量提交汇报 SSTable Checksum 的任务。 |
| PartitionScheduler | storage | 2 | 用来调度转储和调度合并任务。 |
| MemstoreGC | storage | 1 | 用来回收转储预热完成之后的 Frozen MemStore。 |
| ObStoreFile | storage | 1 | 用来检查坏块和宏块回收。 |
| PartSerCb | storage | 40 | 用于分区 Leader 上任、卸任任务处理(20 个线程)。 |
| ObPartitionSplit Worker | storage | 1 | 用于处理分区分裂的后台任务。 |
| FreezeTimer | storage | 1 | 检查 MemStore 内存,触发冻结。 |
| RebuildTask | storage | 1 | 调度 D 副本拉取数据。 |
| IndexSche | storage | 1 | 调度建索引任务。 |
| FreInfoReload | storage | 1 | 同步内部表中 Major Freeze 相关信息。 |
| TableMgrGC | storage | 1 | 回收 MemTable,释放内存。 |
| BackupInfoUpdate | storage | 1 | 用于定时刷 Backup 的相关数据。 |
| LogDiskMon | storage | 1 | 用于检测系统多盘的情况。 |
| KVCacheWash | storage | 1 | 用于 KV Cache 的内存清洗。通过配置项 _cache_wash_interval 来控制检测周期,默认是 200ms,取值范围为 [1ms,1m]。 |
| KVCacheRep | storage | 1 | 用于整理 Cache 的内存碎片回收内存,通过配置项 _cache_wash_interval来控制检测周期,默认是200ms,取值范围为 [1ms,1m]。 |
| RSMonitor | RS | 1 | 用来监控当前 RS 的状态。 |
| CacheCalculator | RS | 1 | 用来给 location_cache 和 schema_cache 预留内存。 |
| ObDailyMergeScheduler | RS | 1 | 用来调度每日合并。 |
| ObEmptyServerChecker | RS | 1 | 用来检测 OBServer 上是否不存在副本。 |
| ObFetchPrimaryDDLOperator | RS | 1 | 备库逻辑同步主库系统租户 Schema。 |
| ObFreezeInfoUpdater | RS | 1 | 推动冻结进度和管理快照点回收点。 |
| ObGlobalIndexBuilder | RS | 1 | 调度全局索引的构建。 |
| ObGlobalMaxDecidedTransVersionMgr | RS | 1 | 统计全局最大事务版本号。 |
| ObLeaderCoordinator | RS | 1 | 管理集群中副本 Leader 分布。 |
| ObLogArchiveScheduler | RS | 1 | 负责日志归档。 |
| ObMajorFreezeLauncher | RS | 1 | 负责每日发起定时合并。 |
| ObPartitionSpliter | RS | 1 | 负责调度分区合并。 |
| ObRebalanceTaskMgr | RS | 1 | 负责调度负载均衡任务的执行。 |
| ObRootBackup | RS | 1 | 负责调度备份任务。 |
| ObRootBalancer | RS | 1 | 负责生成负载均衡任务。 |
| ObRsGtsMonitor | RS | 1 | 监控 GTS 实例的分布情况,并基于 GTS 副本的分布,生成迁移或补 GTS 副本任务。 |
| ObRsGtsTaskMgr | RS | 1 | 执行 GTS 副本任务的线程。 |
| ObHeartbeatChecker | RS | 1 | 负责检查和 OBServer 之间的心跳状态。 |
| ObStandbyClusterSchemaProcessor | RS | 1 | 备库副本同步主库的普通租户 Schema。 |
| ObRestoreScheduler | RS | 1 | 负责恢复流程的调度。 |
| ObWorkQueue | RS | 4 | 执行 RS 的异步任务,线程数通过配置项 rootservice_async_task_thread_count 来控制,取值范围为 [1,10]。 |
| ObAsyncTaskQueue | RS | 16 | 执行构建索引的任务。 |
| ObSwitchTaskQueue | RS | 6 | 主备库切换的任务队列,线程数通过配置项 switchover_process_thread_count 来控制,取值范围为 [1, 1000]。 |
| LocalityReload | RS | 1 | 定期刷新 Locality 信息。 |
| RSqlPool | RS | 1 | 备库用来定期维护主库的 RootServer 列表。 |
| ServerTracerTimer | RS | 1 | 用来维护和其他 Server 状态的定时任务。 |
| LogEngine | CLOG | 1 | 统计监控 Clog 盘空间使用情况,执行 Clog 文件的回收操作。 |
| CLGWR | CLOG | 1 | 负责clog item写盘。 |
| ClogHisRep | CLOG | 3 | 分区上下线时,更新 Clog History 内部表。 |
| BatchSubmitCtx | CLOG | 1 | 负责拆分一阶段优化的事务。 |
| LogScanRunnable | CLOG | 4 | OBServer 启动时,负责扫描所有 Clog 文件。 |
| LogStateDri | CLOG | 1 | 负责 Clog 模块主备角色切换、检查副本级联状态。 |
| ObElectionGCThread | election | 1 | 负责 Election 对象内存的回收。 |
| Blacklist | CLOG | 1 | 负责探测与通信目的端 Server 之间的网络是否联通。 |
| BRPC | CLOG | 5 | 负责后台执行 batch_rpc 聚合包发包。 |
| CLOGReqMinor | CLOG | 1 | 根据 Clog 磁盘空间的情况触发 Minor Freeze,加快 Clog 的回收。 |
| LineCache | CLOG | 1 | 用于优化历史数据的同步,Liboblog 场景使用。 |
| EXTLogWash | CLOG | 1 | 频率:100ms。 |
| CLogFileGC | CLOG | 1 | 用于:用于定期回收 Clog 文件。 |
| CKPTLogRep | CLOG | 1 | 用于日志副本的 C heckpoint操作。 |
| RebuildRetry | CLOG | 1 | 用于重试重建分区的任务。 |
| ReplayEngine | CLOG | 物理核 | 用于备机 Clog 的回放。 |
| PxPoolTh | SQL | 0 | 并行执行的线程池,线程数通过系统变量 parallel_max_servers 来控制,默认为 0。 |
| sql_mem_timer | SQL | 1 | 用于自动内存管理。 |
| OmtNodeBalancer | common | 1 | 负责后台刷新多租户信息。 |
| MultiTenant | common | 1 | 负责刷多租户 CPU 配比,用于资源调度。 |
| SignalHandle | common | 1 | 信号处理线程。 |
| LeaseUpdate | common | 3 | 负责 RS 与各个 Server 直接的 Llease 监控。 |
| RsDDL | common | 1 | 负责 RS 的 DDL。 |
| MysqlIO | common | 12 | 负责 MySQL 的链接处理线程。 |
| all_meta_table | common | 8 | 用于 PG 或者分区状态的汇报。 |
| all_pg_partition_ meta_table | common | 8 | 用于 PG 内分区的状态的汇报。 |
| TimerMonitor | common | 1 | 监控内部定时线程动作,对执行时间异常的任务报警。 |
| ConfigMgr | common | 1 | 用于配置项的刷新。 |
| OB_ALOG | common | 1 | 用于系统异步日志的日志落盘。 |
| ELE_ALOG | election | 1 | 用于选举模块异步日志的日志落盘。 |
4.OceanBase 数据库的多租户架构中是如何做到 CPU 资源的有效隔离的?
在 OceanBase 数据库目前发布的版本中,OceanBase 数据库主要依靠控制活跃线程数量(实际消耗 CPU 资源的线程)来控制 CPU 消耗。OceanBase 数据库在创建租户的时候会指定租户资源池,资源池定义的最大 CPU 的 max_cpu 值可以限制租户级别的 CPU 使用,从而做到租户间 CPU 使用的隔离。在 OceanBase 数据库的最新版本中,OceanBase 数据库内核实现了 Cgroup 的隔离来对 CPU 内存和资源进行有效地控制和限制,这需要操作系统级别的配置搭配生效。目前 OceanBase 数据库正在将这个能力整合在工具平台中,使得未来部署的 OceanBase 数据库可以直接利用 Cgroup 隔离实现资源的有效控制和限制。
5.如何读取 OceanBase 数据库 Worker 线程的数量呢?OceanBase 数据库是否会在负载高的时候动态启动新的线程来执行负载呢?
在 observer.log 中, 以关键字 dump tenant info 为主的日志片段里会描述现在 Worker 线程的现有值以及最大值。具体如下:
tocken_count = 分配给该租户的 cpu_count (>min_cpu&&<max_cpu) *cpu_quota_concurrency
举例一个特定的场景, 一台装有 OceanBase 数据库的机器上的租户 T1 配置了 unit_min_cpu = 2, unit_max_cpu=8, 但是在该台机器上配置的 CPU 资源存在超卖。分配给 T1 的实际 CPU 为 5,那么 token_count = 5*cpu_quota_concurrency。
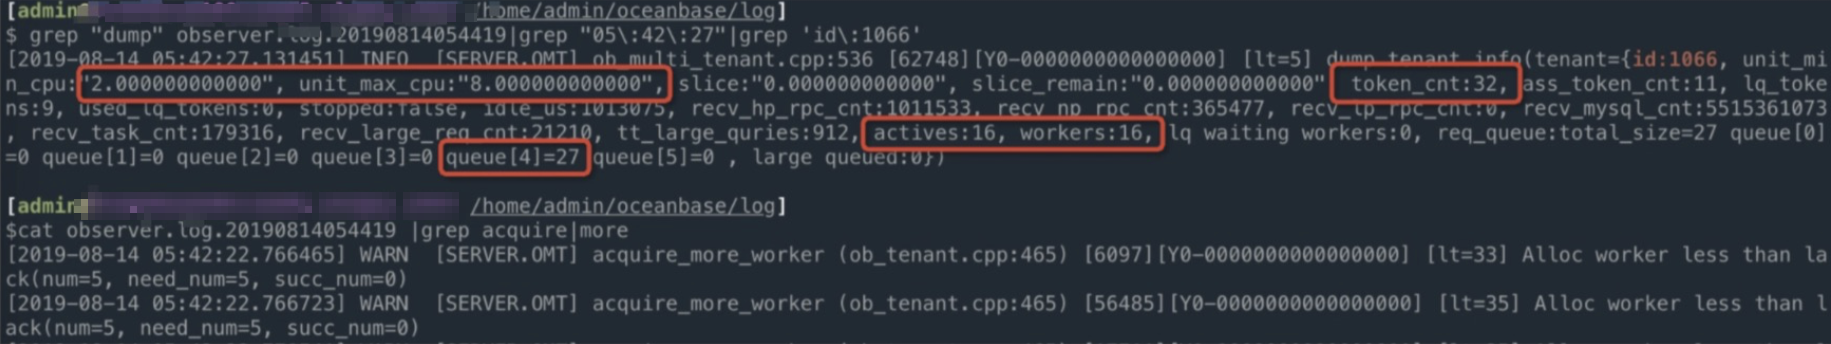
6.OceanBase 数据库是如何对租户活跃线程和线程总数进行控制的?
OceanBase 数据库根据租户的 cpu_count * cpu_quota_concurrency 来计算活跃线程数,这些线程在租户创建的时候就会被创建好。例如,线程 A 是个活跃线程,它因为执行大查询被挂起了,这时活跃线程就少了一个,作为补充,这个租户会额外再创建一个活跃线程。但是一个租户能创建的线程总数也是有限制的,总数限制为 cpu_count* workers_per_cpu_quota。当租户线程数到达上限后,新创建线程会失败,线程 A 不会被挂起,以保持活跃线程数始终不变。举个例子,假设一个租户配置了 16 个 CPU,集群的 cpu_quota_concurrency 设置为2,那么这个租户最多会有 16 * 2 = 32 个活跃的 SQL 线程,控制活跃线程数是 OceanBase 数据库的用户态线程调度器实现的。
7.大查询 CPU 资源分配原则是什么?OLAP 和 OLTP 同时存在的情况下会出现抢占 CPU 资源的情况么?
在使用 OceanBase 数据库时,可以通过配置参数 large_query_threshold 来定义执行时间超过一定阈值的查询操作为大查询。如果系统中同时运行着大查询和小查询,OceanBase 数据库会将一部分 CPU 资源分配给大查询,并通过配置参数 large_query_worker_percentage(默认值为 30%)来限制执行大查询最多可以使用的租户活跃工作线程数。OceanBase 数据库通过限制大查询能使用的租户活跃工作线程数来约束大查询最多能够使用的 CPU 资源,以此来保证系统还会有足够的 CPU 资源来执行 OLTP(例如,交易型的小事务)负载。通过这样的方式来保证对响应时间比较敏感的 OLTP 负载能够得到足够多的 CPU 资源尽快地被执行。另外需要提示的是,虽然 OceanBase 数据库可以做到大查询和 OLTP 资源的分配,large_query_worker_percentage 参数也应设置在一个在合理的范围内,不应该设置成为一个过大的值。否则大查询很容易抢占系统的 CPU 资源而挤进而引发 OLTP 响应过慢甚至队列堆积的问题。
8.如何分析 OBServer 出现 CPU 偏高或者 OBServer Hang 住的情况呢?
当发现 OBServer 的 CPU 负载偏高已经达到了 80%- 90% 甚至以上,该台 OBServer 已经发生了整体性能不佳甚至是 Hang 住的情况,那么可以通过 OBStack 工具(V2.2.3x 高配版本、V2.2.7x 以及 V3.x 版本均可独立安装)获取 OBStack工具。可以直接执行以下命令直接执行 obstack 获取线程栈定向到问题 obstack.trc 中。
[root@hostname /]#obstack ${pid of observer} > obstack.trc
为了快速看到线程栈的热点,还可以利用 OBStack 工具的快速聚集功能,命令如下:
[root@hostname /]#obstack ${pid of observer} -a > obstack.trc


